PROSPECTS AND RISKS OF APPLYING GENERATIVE ARTIFICIAL INTELLIGENCE TECHNOLOGIES IN THE MODERN DIGITAL SCIENTIFIC AND EDUCATIONAL ENVIRONMENT
Введение
Цифровая трансформация научно-образовательной среды характеризуется интенсивным внедрением технологий искусственного интеллекта (ИИ). Большие языковые модели (англ. large language models) предоставляют беспрецедентные возможности в плане персонализации обучения, автоматизации рутинных задач преподавателей и обучающихся, реализации адаптивных образовательных траекторий. Актуальность использования генеративных моделей ИИ в образовательной среде обусловлена необходимостью адаптации традиционных дидактических моделей к условиям избыточности информации. Стремительное развитие технологий ИИ опережает теоретико-методологическое осмысление их влияния на когнитивные процессы. Навык эффективного взаимодействия с нейросетевыми алгоритмами становится важной компетенцией как для научно-педагогических работников, так и для обучающихся.
Возникает острая потребность в разработке научно обоснованных подходов, определяющих этические и методические границы применения моделей генеративного ИИ в цифровой образовательной среде. Академическое сообщество сталкивается с дилеммой: запрет нейросетей ведет к технологическому отставанию, а бесконтрольное использование может привести к деградации аналитических навыков обучающихся [1]. Именно поэтому применение технологий генеративного ИИ требует рационального подхода, в основу которого должны быть положены строгие стандарты качества и достоверности генерируемого контента. Данное противоречие актуализирует запрос на всесторонний анализ механизмов работы нейросетей и их влияния на систему управления научно-образовательными знаниями.
Цель исследования ‑ анализ дидактического потенциала, технологических особенностей и этико-когнитивных рисков применения генеративных моделей искусственного интеллекта в сфере образования для формирования методических рекомендаций по их безопасной интеграции в образовательный процесс.
Материал и методы исследования
Становление текстовых нейросетей в России неразрывно связано с формированием суверенной нормативно-технологической базы, обеспечивающей безопасность и предсказуемость систем искусственного интеллекта. Принципы правового регулирования отношений в сфере разработки, внедрения и применения больших фундаментальных моделей искусственного интеллекта сформулированы в Федеральном законе от 26.07.2026 № 243-ФЗ «О поддержке развития технологий искусственного интеллекта в Российской Федерации»[1]. Закон также вводит две категории моделей искусственного интеллекта (суверенные, национальные) и предусматривает предоставление пользователям возможности размещения маркировки (информационного предупреждения) информационных материалов в аудио- и (или) визуальной форме, созданных с использованием ИИ. Разработка национальных моделей, таких как YandexGPT и GigaChat, требует применения адекватного правового поля, регулирующего вопросы доверия к сгенерированному с помощью нейросетей контенту. Ключевыми документами в данном случае являются государственные стандарты ГОСТР59276-2020 «Системы искусственного интеллекта. Способы обеспечения доверия»[2] и ГОСТ Р 59277-2020. «Системы искусственного интеллекта. Классификация систем искусственного интеллекта»[3]. Эти документы устанавливают жесткие требования к прозрачности алгоритмов, верифицируемости наборов данных, защите персональной информации пользователей, определяют классификацию систем ИИ по степени потенциальной угрозы, что обязывает разработчиков образовательного программного обеспечения внедрять механизмы интерпретируемости результатов. Введение стандартизации позволило перейти от хаотичного тестирования нейросетей к их системной интеграции в защищенные образовательные контуры отечественных вузов [2]. Для современной цифровой научно-образовательной среды ГОСТы имеют критическое значение, так как они регламентируют уровень допустимого риска при принятии автоматизированных решений, что напрямую влияет на процессы оценивания компетенций обучающихся.
Работа является обзорно-аналитическим исследованием. Материалами исследования послужили нормативные документы, статистические данные и аналитические публикации, отражающие развитие и применение технологий генеративного искусственного интеллекта в современной цифровой научно-образовательной среде.
Результаты исследования и их обсуждение
Интеграция технологий генеративного искусственного интеллекта в сферу управления знаниями открывает перспективы создания и развития динамических онтологий и автоматизированных баз компетенций (систем сбора, хранения, анализа и оценки навыков, знаний и профессиональных качеств преподавателей и обучающихся). В конечном итоге возможен переход от статических хранилищ информации к диалоговым агентам, способным мгновенно извлекать, синтезировать и адаптировать междисциплинарные знания под конкретные запросы как теоретика, так и исследователя. Это многократно ускоряет процессы адаптации молодых специалистов, позволяя им быстрее ориентироваться в массивах публикаций, посвященных теоретическим и прикладным исследованиям. ИИ способен выявлять скрытые связи между разрозненными исследованиями, выступая мощным инструментом генерации научных гипотез, систематизации и обобщения лучших практик и передового опыта [3; 4].
По данным исследования, проведенного в Национальном исследовательском университете ИТМО в 2024 году (внутренний опрос университетов ИТМО и НИУ ВШЭ), около 50% студентов признают, что использовали ИИ при сдаче заданий, а 40% преподавателей генерируют программы дисциплин с помощью нейросетей (рис. 1).
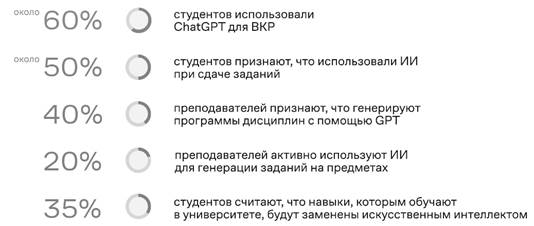
Рис. 1. Статистика проникновения технологий ИИ в образовательный процесс
Источник: Искусственный интеллект и высшее образование: возможности, практики и будущее. Яндекс Образование. URL: https://education.yandex.ru/aihighreport/ (дата обращения: 18.05.2026).
Однако перечисленные перспективы связаны с серьезными эпистемологическими рисками, предполагающими вероятность получения ложного, искаженного или неподтвержденного знания. Главный вызов академической честности - угроза неконтролируемого плагиата нового типа (ИИ-плагиат), который не всегда детектируется существующими системами антиплагиата [5]. Более глубокий риск кроется в феномене когнитивной разгрузки (cognitive offloading). Обучающиеся, делегирующие аналитическую работу алгоритмам, рискуют утратить навыки критического мышления, глубинного чтения и самостоятельного анализа и синтеза смыслов. Возникает иллюзия компетентности: обучающийся путает доступ к информации с реальным владением знаниями.
Другая серьёзная проблема связана с возможной систематической погрешностью исходных массивов данных, которые используются для обучения нейросетей. Если обучающие наборы данных содержат неточную информацию или однобокие представления, это может транслироваться в искаженные ответы модели и формировать недостоверную научную картину мира, особенно при отсутствии навыков критической проверки машинных выводов [6]. В такой ситуации система управления знаниями может подменить достоверные факты симулякрами, то есть образами и утверждениями, не имеющими эмпирического обоснования. Чтобы не допустить этого, необходимо внедрять жесткие регламенты проверки достоверности (фактчекинг) и оценки оригинальности мышления [7].
Для грамотного использования генеративных моделей ИИ в учебном процессе необходимо глубокое понимание их архитектурной специфики и основ функционирования [8]. Современные нейросети используют архитектуру Transformer, которая кардинально изменила подходы к обработке естественного языка Natural Language Processing [9]. В отличие от рекуррентных нейронных сетей прошлых поколений архитектура Transformer даёт возможность обрабатывать входные данные параллельно, а не последовательно. Это достигается за счет механизма внимания Self-Attention, который позволяет модели оценивать важность каждого слова (токена) в контексте всего предложения, улавливая сложные синтаксические и семантические связи [9; 10].
Процесс обучения нейросети включает несколько этапов. На этапе предварительного обучения Pre-training нейросеть обрабатывает терабайты неструктурированных текстовых данных, формируя статистическую модель языка [11]. На этой стадии нейросеть ещё не обладает «знаниями» в человеческом понимании, она лишь вычисляет вероятности появления следующего слова в зависимости от предыдущего контекста.
Однако для образовательного процесса неконтролируемая генерация текста неприемлема, поскольку нередко порождает «галлюцинации», то есть грамматически корректные, но фактически ложные утверждения [6]. Для решения этой проблемы применяют этап тонкой настройки Fine-tuning и метод обучения с подкреплением на основе отзывов людей [11]. Этот метод превращает первоначально стохастический генератор текста в интеллектуального диалогового помощника, который способен следовать инструкциям, соблюдать этические нормы и отклонять деструктивные запросы. Для педагога крайне важно осознавать, что нейросеть не ищет информацию в базе данных, а конструирует ответ в реальном времени, опираясь на внутренние весовые коэффициенты своей модели.
Не менее значим и процесс токенизации, предполагающий разбиение текста на элементарные смысловые единицы (фрагменты) [9]. Токенизация русскоязычных текстов сложнее англоязычных из-за богатой морфологии, что ранее приводило к снижению качества генерации у зарубежных нейросетевых моделей.
Отечественные разработки оптимизировали свои токенизаторы под кириллицу. Как следствие, значительно повысилась связность и академическая точность генерируемых текстов. Всегда следует помнить, что генеративный ИИ не является энциклопедией, а представляет собой сложную статистическую функцию аппроксимации паттернов человеческой речи. Обучающиеся должны усвоить, что результат работы нейросети подлежит обязательной проверке по первоисточникам, а сама она лишь вспомогательный генератор идей, но не безусловный источник истины [12; 13].
В таблице приведены результаты сравнительного анализа больших языковых моделей по критериям, критически важным для образовательного процесса.
Сравнительный анализ больших языковых моделей
|
Нейросеть (LLM) |
Объем контекста (токенов) |
Качество генерации на русском языке |
Склонность к галлюцинациям |
Способность к сложной логике/кодингу |
Доступность и интеграция в РФ |
|
ChatGPT (GPT-5.6 Terra) |
До 1 млн |
Очень высокое |
Низкая |
Эталонная, глубокая аналитика |
Ограниченная, геоблокировки |
|
GigaChat (3.5 Ultra) |
До 131k |
Отличное (нативная кириллица) |
Средняя |
Базовая логика, хороший пересказ |
Полная, API для вузов РФ |
|
YandexGPT (5 Pro) |
До 32k |
Отличное (нативная кириллица) |
Средняя |
Хорошая аналитика текстов |
Полная, встроена в экосистему |
|
Claude (Opus 4.8) |
До 1 млн |
Высокое |
Низкая (высокая надежность) |
Высокая, анализ больших PDF |
Ограниченная, сложная регистрация |
|
Gemini (3.1 Pro / 3.5 Flash) |
До 1 млн+ |
Хорошее |
Умеренная |
Быстрая работа с данными Google |
Ограниченная, геоблокировки |
|
DeepSeek-R1 |
До 163k |
Хорошее |
Умеренная |
Эталонная, глубокая аналитика |
Полная (MIT Open Source) |
Примечание: составлено авторами на основе данных: Chávez J., Crossa S. LLM Stats: AI Benchmarking Hub. 2025. URL: https://llm-stats.com/ (дата обращения: 04.09.2026) и [5; 11; 14].
Проведённый анализ больших языковых моделей выявил значительный разброс характеристик доступных нейросетевых решений. Ключевым событием, существенно меняющим образовательный технологический ландшафт, стало появление модели DeepSeek-R1 [14], которая благодаря применению методов обучения с подкреплением демонстрирует способность к построению развёрнутых цепочек рассуждений. Это позволяет алгоритму последовательно верифицировать промежуточные вычисления, что повышает достоверность итоговых результатов при решении математических, алгоритмических и аналитических задач.
Для системы образования России особую ценность представляет лицензия MIT, под которой распространяется DeepSeek-R1. Лицензия MIT позволяет развёртывать модель DeepSeek-R1 на собственных серверах образовательных организаций. Локальное развёртывание может упростить контроль данных при условии отдельной правовой и технической оценки.
Модели YandexGPT и GigaChat сохраняют статус надёжных и доступных средств для повседневных образовательных практик. Интеграция в российские цифровые платформы и адаптация к морфологии русского языка делают их предпочтительным выбором при выполнении массовых задач, таких как подготовка первоначальных вариантов текстов, реферирование русскоязычных источников. Зарубежные модели Claude и Gemini Pro с расширенным контекстным окном целесообразно применять для исследовательских задач высокой сложности, например при семантическом анализе многотомных собраний публикаций в формате PDF [15].
С учетом разнообразных возможностей и широкого выбора больших языковых моделей наиболее рациональной представляется гибридная модель построения ИИ-инфраструктуры образовательного учреждения. Для оперативного внедрения в системы управления обучением оптимально сочетать решения YandexGPT и GigaChat с локальными развернутыми моделями семейства DeepSeek, обеспечивающими надёжную логическую обработку без рисков утечки данных. Международные научно-образовательные проекты могут потребовать обращения к зарубежным флагманским моделям ИИ, однако в таких случаях обязателен жёсткий контроль за передаваемыми данными и неукоснительное соблюдение принципов информационной безопасности.
Эффективность взаимодействия с генеративными моделями ИИ напрямую зависит от качества формулировки запроса - промпт-инжиниринга [8]. В образовательном контексте результативный промпт должен строиться в соответствии со строгой структурой, исключающей вариативность толкования. Правильный промпт включает элементы [7]: роль, задача, контекст, формат вывода, ограничения (рис. 2).
Элемент промпта «роль» калибрует лексикон и глубину анализа нейросети (например, «действуй как строгий рецензент научных статей»).
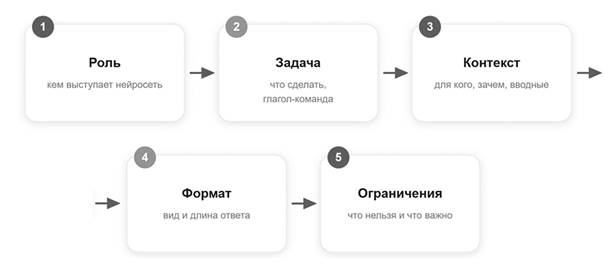
Рис. 2. Структура правильного промпта.
Источник: Как писать промпты для нейросетей: ChatGPT и другие нейросети.
URL: https://ya.zerocoder.ru/kak-pisat-effektivnye-promty-dlya-nejroseti//(дата обращения: 25.05.2026).
Элемент «задача» должен содержать глаголы («сравни», «классифицируй», «выдели», «найди»), а не абстрактные просьбы. Элемент «контекст» обеспечивает привязку к конкретной дисциплине или ограничению (например, «используй статистические данные 2024-2026 гг.»).
Формат вывода жестко задает структуру ответа на запрос к нейросети (например, таблица, маркированный список, эссе объемом строго до 1000 слов). В промпт также следует включать элемент «ограничения» на галлюцинации - прямое указание нейросети отвечать «не знаю», если информации в её моделях недостаточно. Владение компетенциями промпт-инжиниринга переводит обучающихся из позиции пассивного потребителя информации в позицию архитектора запросов, развивая системное мышление.
Заключение
Проведённое исследование подтверждает, что технологии генеративного искусственного интеллекта стали неотъемлемым элементом современной цифровой научно-образовательной среды. В работе проведен анализ дидактического потенциала и этико-когнитивных рисков применения генеративных моделей искусственного интеллекта в сфере образования, охарактеризованы архитектурные особенности нейросетей, проиллюстрирована структура результативного промпта. Сравнительный анализ больших языковых моделей показал, что оптимальным подходом для образовательных организаций является формирование гибридной ИИ-инфраструктуры, включающей модели YandexGPT и GigaChat. Эти модели целесообразно использовать для рутинных задач (генерация черновиков, суммаризация текста, работа с источниками), а локально развёрнутые модели семейства DeepSeek-R1 - для решения сложных аналитических и математических задач.
Для преподавателей технологии генеративного искусственного интеллекта выступают эффективным инструментом автоматизации разработки учебно-методических материалов, создания многовариантных тестовых заданий, подготовки примеров и кейсов, предварительной обработки больших массивов научной литературы. Для обучающихся технологии ИИ открывают перспективы быстрого доступа к инструментам структурирования идей, языкового перевода, первичного анализа данных. Однако при интенсивном использовании нейросетей возникают риски галлюцинации модели, угрозы ИИ-плагиата, эффекты когнитивной разгрузки, ведущие к ослаблению критического мышления.
Для снижения названных рисков предлагается реализация следующих мер: обязательная фактологическая верификация всех нейросетевых выводов, переориентация системы оценивания с проверки письменных работ на защиту проектов и устные дискуссии, формирование у обучающихся и преподавателей компетенций в области промпт-инжиниринга и цифровой гигиены. Важным условием безопасной интеграции генеративных моделей выступает понимание того, что ИИ является лишь катализатором идей, но не заменой аналитическому мышлению. Только при таком подходе генеративный искусственный интеллект может стать надёжным инструментом повышения когнитивных способностей человека в образовательной среде.
Conflict of Interest
Funding
Bibliographic Reference
URL: https://www.science-education.ru/en/article/view?id=34730 (accessed: 12/10/2026).
DOI: https://doi.org/10.17513/spno.34730